Documenten doorzoekbaar maken, zonder de mappenstructuur te hertekenen.
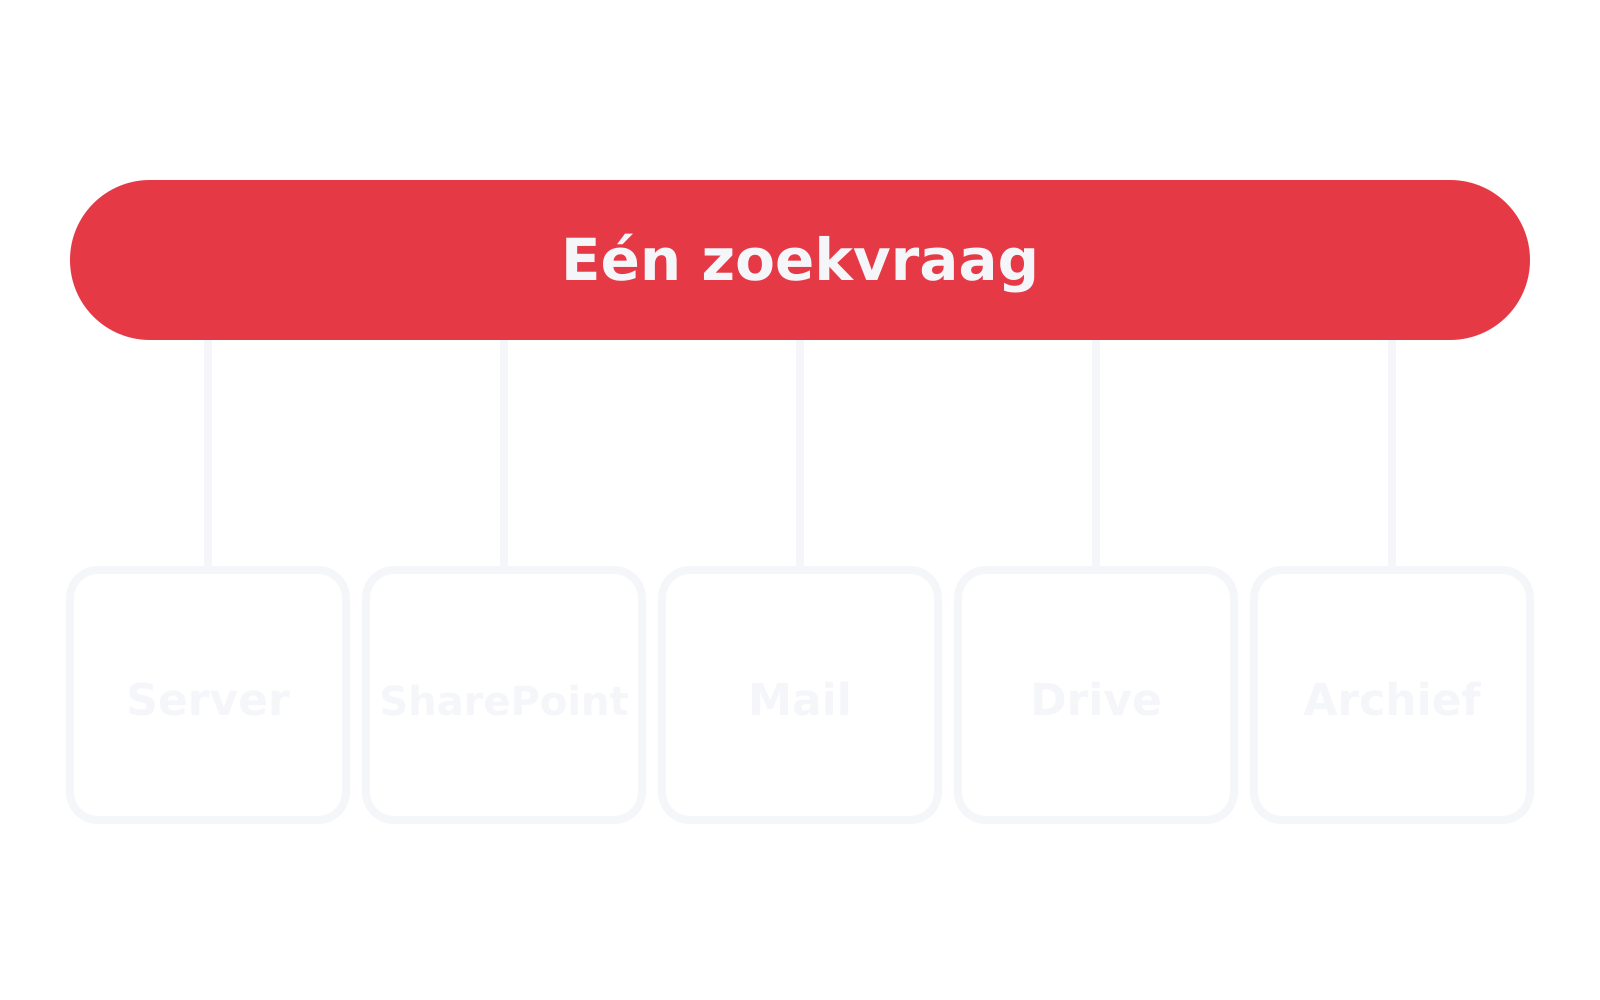
Handleidingen, procedures, offertes, klantendossiers, productfiches. Informatie zit verspreid over PDF’s, Word, SharePoint, mailboxen en netwerkschijven. Een AI-kennissysteem doorzoekt alles en antwoordt in gewone taal, met bronvermelding. Bestanden blijven waar ze staan.
Vier realiteiten die elke KMO met veel documenten kent.
Informatie zit dikwijls versnipperd over meerdere systemen. Vier patronen keren structureel terug, en kosten samen meer tijd dan iemand goed inschat.
“Waar staat dat document ook alweer?”
Een collega uit vakantie, een klantvraag over een oud project, een detail uit een handleiding. De informatie bestaat, maar niemand weet meer waar. Zoeken duurt vijf minuten, of een uur, of niemand vindt het en de vraag blijft onbeantwoord.
Hetzelfde dubbel zoeken door verschillende mensen
Verkoper A zoekt productinfo voor klant X. Twee dagen later doet verkoper B hetzelfde voor klant Y. Elk zoekt dertig minuten, elk vindt het antwoord op zijn manier, geen van beiden weet dat de andere hetzelfde deed.
Kennis van vertrekkende medewerkers verdwijnt
Iemand met tien jaar in het bedrijf gaat weg. Zijn mailbox wordt gearchiveerd, zijn documenten belanden in een map die niemand meer opent. De kennis over klanten, projecten en beslissingen verdampt langzaam.
Nieuwe medewerkers vinden de weg niet terug
Onboarding kost weken, dikwijls omdat nieuwe collega’s telkens aan iemand anders moeten vragen “waar staat dat?” Vragen die de ervaren collega’s al lang moe zijn. Kennisoverdracht wordt een last die de dagelijkse werking vertraagt.
Vier dingen die AI met jouw bedrijfsdocumenten doet.
Elke capability sluit direct aan bij een pijnpunt hierboven. En het uitgangspunt blijft: documenten verhuizen niet, ze worden alleen doorzoekbaar.
Alles centraal doorzoekbaar zonder migratie
PDF’s, Word, Excel, PowerPoint, e-mails, SharePoint, netwerkschijven, cloud-opslag. Alles wordt geïndexeerd waar het staat. Zoeken gebeurt vanuit één interface, bestanden verhuizen niet. Je bestaande mappenstructuur blijft intact.
Antwoord in mensentaal, niet in zoekresultaten
Je stelt de vraag zoals aan een collega. “Wat was ook alweer onze standaardclausule voor annulering bij projectwerk?” Antwoord komt in enkele zinnen, met de bron erbij. Geen tien PDF’s om zelf door te klikken.
Bronvermelding, altijd
Elk antwoord toont welke documenten gebruikt werden, met klikbare links. Twijfelt iemand aan het antwoord? Directe controle op de bron. Bruikbaar voor situaties waar traceerbaarheid telt (juridisch, financieel, technisch, gereguleerde sectoren).
Rechten en meertaligheid ingebouwd
Wat vertrouwelijk moet blijven, blijft vertrouwelijk. Rechten worden per rol, team of documenttype ingesteld. Zoeken en antwoorden werkt in Nederlands, Frans, Engels en Duits, en in veel meer talen: klant vraagt in het Frans, antwoord komt in het Frans, ook al staat de bron in het Nederlands.
Van verspreide documenten naar doorzoekbare kennis in drie tot zes weken.
Vijf fasen, in korte iteraties. Voor grotere kennisbases (10.000+ documenten) of complexe formaten kan het langer duren.
Inventarisatie van documentbronnen
Samen bepalen we welke bestanden in het systeem komen: welke mappen, welke SharePoint-sites, welke mailboxen, welke cloud-opslag. Duidelijke afbakening voor we starten, inclusief welke documenten expliciet buiten scope blijven.
Verwerken en indexeren
Documenten worden opgeschoond, gestructureerd en geïndexeerd. Dubbels eruit, oude versies vergeleken met huidige, structuur toegevoegd waar het ontbreekt. Dit gebeurt achter de schermen, jij hoeft er niets aan te doen.
Interface bouwen en testen met je team
De zoek-interface wordt gebouwd (webinterface, chat, geïntegreerd in je bestaande software). We testen met echte vragen van echte gebruikers, meten hoe vaak het correct antwoordt, sturen bij tot de betrouwbaarheid op peil is.
Uitrol en integratie in dagelijks gebruik
Live zetten met korte introductie voor het team. Waar mogelijk integratie in bestaande tools (bijvoorbeeld via een chat-widget of een knop in je huidige software) zodat gebruikers geen extra tool hoeven te openen.
Onderhoud en uitbreiding
Nieuwe documenten kunnen automatisch (via koppelingen) of manueel worden toegevoegd. We stellen samen in hoe updates verlopen: automatisch bij wijziging, wekelijks per map, of per document. Uitbreiden naar nieuwe bronnen kan later.
Documenten blijven binnen jouw controle. We werken met Europese hosting of on-premise waar nodig, en leggen data-flow, toegangsrechten en bewaartermijn vooraf schriftelijk vast. Gevoelige documenten kunnen apart worden geïndexeerd met strengere toegangscontrole per rol of team.
Impaxo werkt met een vaste poule Belgische en Nederlandse developers waarmee ik al jaren samenwerk. Zij hebben ervaring met de bronnen waar dit project naartoe moet: documentbeheer, netwerkschijven, SharePoint en mailarchieven, elk met hun eigen rechtenstructuur. Ik ben zelf architect en gesprekspartner. Geen wisselend team dat komt en gaat.
Wil je verder kijken?
Documenten doorzoekbaar maken past in een bredere aanpak. Kies wat het meest aansluit bij wat jij verder wil oplossen.
Vragen bij documenten doorzoekbaar maken.
Klaar om jullie bedrijfskennis vindbaar te maken?
Boek een gesprek van 30 minuten. We bekijken samen welke documenten prioriteit krijgen.